DatabricksのLakeflow SDPを実践した感想
Lakeflow SDPのLevel 1〜5を実装して感じた、MVとSTの使いやすさ、データ品質チェック、AUTO CDCによる履歴管理、dbtとの比較をまとめます。
目次 7項目
DatabricksのLakeflow Spark Declarative Pipelines(以下、SDP)を実際に触ってみました。「Lakeflow SDP入門:基礎から実践まで」のLevel 1から5までを、Databricks上で実装しています。この記事はDatabricks JapanのYayoiさんの記事を参考にしています。日本でDatabricksを扱っている人で知らない人はいないと思われるDatabricksの神、Yayoiさんのレッスンです。
率直な感想は、かなり使いやすいです。SQLで変換を書き、データの持ち方を選び、品質ルールを添える。その延長で差分の取り込みや履歴管理まで構築できるところがよかったです。
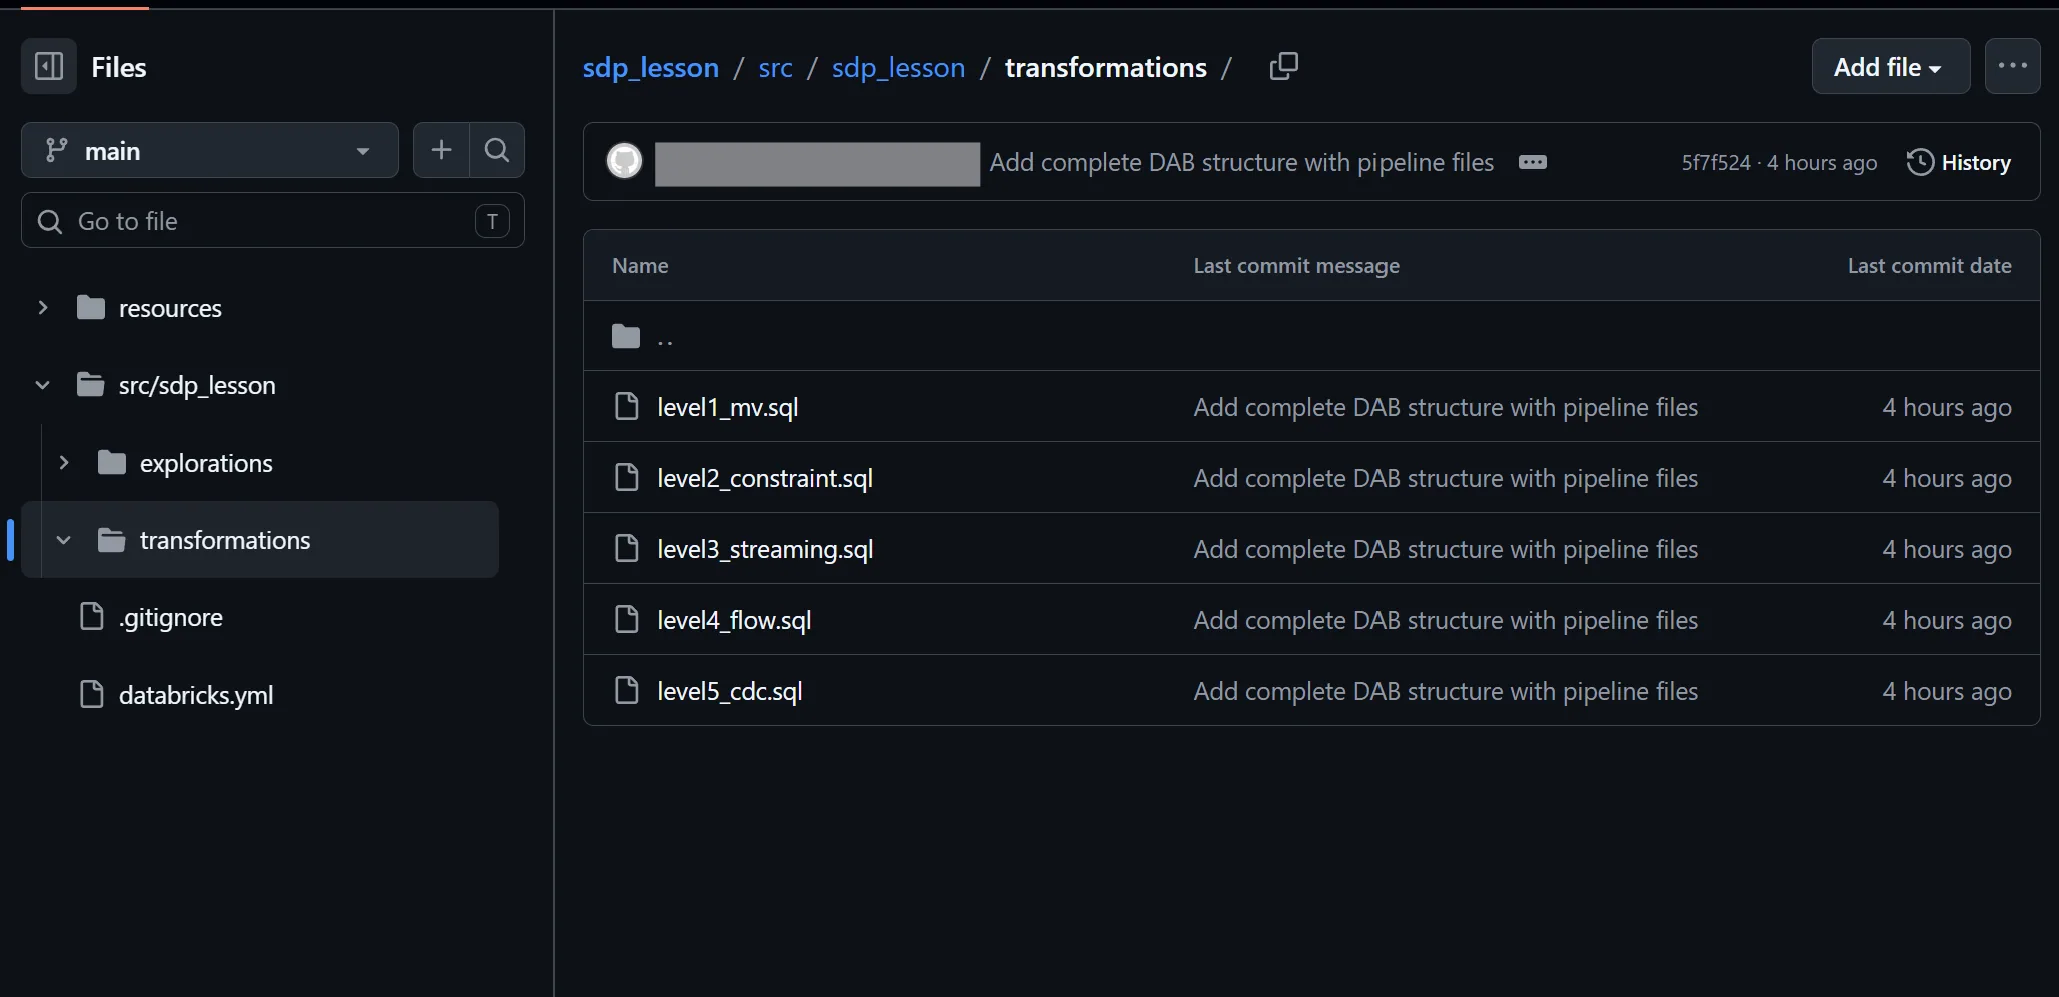
実装したコードは下記のようにLevelごとにファイルを分けています。GitHubのsdp_lessonリポジトリで公開しています。手順は参考記事にまとまっているので、今回は使ってみて感じたことを中心に書きます。
Level 1から5まで触ってみて
今回のコードでは、注文データの集計から始めて、品質チェック、CSVの増分取り込み、複数のフローによる統合、マスターの同期までを扱いました。
最初は「SQLで集計テーブルを作る仕組み」という印象でしたが、最後まで進めると、データを継続的に育てていくための仕組みだと感じます。取り込んだ後の品質や変更の扱いまで、同じパイプラインの中で考えられるのがよいです。
特に好印象だったのは、処理が増えても、コードから「どんなデータを作りたいのか」を追いやすいことです。集計、品質ルール、取り込み、履歴管理それぞれの意図が見えるので、後から読み返すときにも助かりそうです。
MVとSTを軸に考えられるのが分かりやすい
いちばん気に入ったのは、マテリアライズドビュー(MV)とストリーミングテーブル(ST)を軸に設計を考えられるところです。
最初の感覚としては、「全件洗い替えならMV、差分更新ならST」と整理できるのが分かりやすいと思いました。ただ、正確にはMVが毎回全件を再計算するわけではありません。MVはクエリの結果を最新の状態に保つもので、条件に応じて増分更新も行われます。公式ドキュメントの更新方式の説明を踏まえると、次のように捉えるのがよさそうです。
| 種類 | 今回の使いどころ | 設計するときの考え方 |
|---|---|---|
| MV | 日別の売上集計 | 現在の元データに対するクエリ結果を保ちたい |
| ST | CSVの取り込み、取り込んだ注文の加工 | 新しく到着したデータを継続的に処理したい |
実際にLevel 3のコードでは、取り込みと品質チェックにSTを使い、その後の日別集計にMVを使っています。この組み合わせは、処理の目的と対応していて納得しやすかったです。
もちろん、STを選べば元データの更新や削除まで何でも自動で反映される、という意味ではありません。今回の追記フローと、後述するAUTO CDCによる変更反映は区別して考える必要があります。
それでも、差分の管理をすべて自分で書くところから始めずに済むのはありがたいです。「このデータをどう使いたいか」に集中しやすいと感じました。
テストや品質チェックを処理に組み込みやすい
テストの行いやすさも好印象でした。特に、エクスペクテーションで品質条件を変換の定義に添えられるところが便利です。
今回のコードでは、金額や日付、注文ステータスなどに条件を付けています。単に条件を書くことに加えて、違反したデータをどう扱うかまで指定できるのがよいです。
エクスペクテーションの公式仕様では、違反行を残して計測する、除外する、更新を失敗させる、という扱いを選べます。業務上の重要度に合わせてルールを変えられるので、「とりあえず全部エラーにする」以外の設計がしやすいと感じます。
例えば、必須の項目が欠けているデータと、少し気になる値が入っているデータでは、求める対応が違います。その違いをコードに残せると、レビューでも意図を伝えやすそうです。
ただし、ここで便利だと感じた品質チェックと、変換ロジックの単体テストは分けて考えたいです。金額が正の数であることを確認できても、集計結果が業務上正しいことまで保証できるわけではありません。期待する入力と出力の比較や、結合で件数が増えていないかの確認は、別途用意したいところです。
フローを分けられると、後から処理を足しやすそう
Level 4では、オンライン注文と実店舗注文を同じテーブルに流し込み、過去データを取り込むフローも定義しました。
ここでよかったのは、保存先のテーブルと、そこへデータを入れる処理を分けて書けることです。コードを読む側からすると、「何をためる場所なのか」と「どこから入ってくるのか」を順番に確認できます。
実務でも、最初は一つだった入力元が後から増えたり、過去分を追加で取り込みたくなったりすることはありそうです。そのときに既存の処理を大きく書き換えず、フローを追加する形で考えられるのは扱いやすいと思いました。
これは今後への期待ですが、取り込み元ごとに処理が分かれていれば、変更のレビューや問題箇所の切り分けもしやすそうです。
SCD Type 1・Type 2を簡潔に書けるのがうれしい
AUTO CDCは、今回触った中でも特に便利だと感じた機能です。
SCD Type 1は最新の状態に更新する方式、Type 2は変更履歴を残す方式です。これを自分で組み立てる場合、更新対象の判定や履歴の有効期間など、気を配る箇所が増えます。
SDPではAUTO CDCに、キー、変更の順序、削除条件、履歴の持ち方を宣言できます。今回の顧客データでも、同じ変更データから最新状態のテーブルと履歴テーブルを作っています。
Level 5のコードを見ると、最新状態を保つ定義と履歴を残す定義を、よく似た形で記述できています。Type 2側ではSTORED AS SCD TYPE 2を指定しており、何を実現したい処理なのかが読み取りやすいです。
履歴管理は必要になる場面が多い一方、毎回細かな実装を抱えたくない部分でもあります。そこをフレームワークに任せられるのは、かなり魅力的でした。
一方で、キーと順序の設計は自分で決める必要があります。今回ならidとevent_timeです。実際のデータでは、同じ時刻の変更をどう区別するか、遅れて届いた変更をどう確認するかなども考えたいです。記述が簡単になる分、こうしたデータの意味に時間を使えそうだと感じます。
dbtと比較しても、今回の範囲では遜色ない
以前、dbt CoreとDatabricksを接続する記事を書きました。今回SDPを触ってみて、SQLで変換を定義し、品質を確認しながらデータを作るという範囲では、dbtと比較しても遜色ないと感じています。
これは機能や性能を網羅的に比較した結果ではなく、ハンズオンでの使い勝手についての感想です。特に、差分の取り込みから履歴管理までDatabricks上でつながるところは、SDPの魅力だと思います。
比較するときに意識したいのは、似た目的の機能でも動き方が同じとは限らないことです。例えば、dbtのデータテストはデータに対する条件を検証するもので、SDPのエクスペクテーションには処理中の違反行を除外する選択肢もあります。また、dbtのスナップショットによるType 2の履歴管理と、今回の変更イベントを入力するAUTO CDCでは、変更を捉える方法が異なります。
あとは、ドキュメンテーションについてはdbtに軍配が上がります。Unity Catalogを見ればテーブル構造などは分かるのですが、dbtはdbt docs generateでドキュメントサイトを静的ファイルとして生成できるので、別の場所で共有しやすい点が便利です。
とはいえ、単純に機能名を並べて勝ち負けを決めるより、手元の入力データや運用に合うかで選びたいです。すでにdbtで整えているモデルや開発の仕組みがあるなら、それも判断材料になります。
少なくとも今回の体験では、Databricksで新しくパイプラインを作るとき、SDPを有力な候補として考えたいと思いました。
次は運用に近い条件でも試したい
今回のハンズオンで、構築のしやすさにはかなりよい印象を持ちました。次に確認したいのは、動かし続けるときの使い勝手です。
- データ量や実行頻度を変えたときの処理時間とコスト
- スキーマや変換ロジックを変更した後の再処理
- 遅れて届く変更や、同じデータを再投入した場合の結果
- Gitでの変更管理から、開発環境・本番環境への反映までの流れ
このあたりは、今回の実装だけで評価しきれたとは考えていません。ただ、基本的な処理を短く書ける分、運用を見据えた検証にも進みやすそうです。
SDPを触っていちばんよかったのは、実現したいデータ処理を素直に書けることでした。MVとSTの使い分け、品質チェック、SCD Type 1・Type 2の構築まで、段階的に理解できたのもよかったです。
まだハンズオンを終えた段階ですが、「次もこれで作ってみたい」と思えるフレームワークでした。